Guia de implementação
Poka-Yoke.
Poka-Yoke é a prática lean de tornar o processo à prova de erros, para que o engano humano ou não possa acontecer ou fique visível no instante em que acontece, na própria estação. O alvo é o erro, não o operador: onde um engano é possível, turnos suficientes acabam produzindo esse erro. Bom dispositivo é simples, cabe dentro do ciclo e ganha tanto da inspeção final quanto de mais um registro de treinamento. Prevenir vale mais que detectar, e detectar na estação vale mais que inspecionar no fim da linha.
O que é Poka-Yoke
Poka-Yoke é japonês para evitar o engano involuntário, e na indústria dá nome a uma disciplina de projeto bem específica: mudar a peça, o dispositivo, a ferramenta ou a sequência para que o engano humano ou não possa acontecer fisicamente ou fique visível dentro do mesmo ciclo, na estação onde aconteceu. Um conector chaveado que não encaixa ao contrário é poka-yoke. Uma parafusadeira que conta os apertos e se recusa a liberar a unidade enquanto cada junta não fechar um ciclo bom também é.
A ideia vem de Shigeo Shingo e do Sistema Toyota de Produção, e o movimento central dela é uma distinção que a maioria dos sistemas da qualidade embaralha: erro não é defeito. Erros, um passo pulado, uma peça invertida, uma retirada errada, são uma saída normal da atenção humana fazendo trabalho repetitivo. Defeito é erro que deixaram seguir adiante. A inspeção aceita a ligação entre os dois e tenta filtrar o resultado. O poka-yoke corta a ligação.
Por isso o alvo honesto é o erro, não o operador. A 456 unidades por dia, um modo de erro com chance de um em dez mil por ciclo aparece mais ou menos a cada três semanas, para sempre, não importa quem esteja no turno. Etiqueta de aviso e registro de treinamento não mudam essa conta. Um pino no dispositivo muda. Onde o engano é possível, turnos suficientes acabam produzindo esse erro, e então as opções reais são três: tornar impossível, tornar imediatamente visível ou se conformar em descobrir no cliente, para sempre.
Onde o poka-yoke entra no roadmap da transformação
No roadmap de implantação do TeamGuru, os dispositivos à prova de erros pertencem à prática de equipamentos e métodos da etapa Melhorar, ao lado de SMED e TPM. É uma disciplina de contramedida, ou seja, precisa de uma lista de alvos: as linhas prioritárias de um FMEA vivo e as causas comprovadas que voltam sempre nos casos de análise de causa raiz e ações corretivas são de onde saem os bons projetos de poka-yoke. Dispositivo feito sem esse trabalho antes é um palpite com sensor pendurado.
- Antes Gerenciamento diário
- Você está aqui SMED, TPM, FMEA e Poka-Yoke
- Em paralelo Kaizen
- Depois Obeya e análise crítica pela direção
Quando não fazer um poka-yoke
O trabalho à prova de erros tem direito forte sobre qualquer orçamento da qualidade, e é justamente por isso que precisa de critérios de ainda não. Não construa um dispositivo quando:
- Você não consegue descrever como o erro acontece. Se a equipe não viu o engano acontecer, nem conseguiu reproduzi-lo, o dispositivo vai travar um palpite. Automatizar uma teoria errada dá uma estação mais difícil de operar e exatamente tão desprotegida quanto antes.
- O risco é irrelevante e o defeito principal continua aberto. Encher de sensor um modo de erro cosmético enquanto o escape número um para o cliente segue sem barreira é erro de prioridade. Ordene os modos de erro por consequência e por histórico de escape primeiro, depois trabalhe a lista.
- O passo pode simplesmente ser eliminado. Se uma junta parafusada pode virar uma conformação da peça, ou um lançamento manual pode virar leitura de código de barras, tirar a oportunidade ganha de protegê-la. Eliminar está no topo da hierarquia abaixo, e é o primeiro a ser checado.
Como implantar um dispositivo
Um modo de erro por vez, no processo, com a equipe. A sequência:
-
Escolha o principal modo de escape.
Tire da lista de prioridades do FMEA, das causas raiz que se repetem e do histórico de reclamações de cliente, não do que parece mais fácil de instrumentar com um sensor. Um modo de erro, uma estação, um dispositivo. Programa de dispositivos à prova de erros lançado na fábrica inteira de uma vez produz principalmente reunião.
-
Estude como o erro acontece de verdade.
Acompanhe ciclos reais na estação, inclusive no fim do turno, no setup e no retrabalho, porque é aí que os erros se concentram. Pergunte aos operadores onde estão as armadilhas: eles costumam saber de cor o quase acidente que evitam toda semana. Escreva o mecanismo do erro em uma frase antes de projetar qualquer coisa.
-
Escolha o nível mais alto da hierarquia que for viável.
Prevenir vale mais que detectar, detectar na estação vale mais que detectar no processo seguinte, e qualquer um deles vale mais que inspeção no fim da linha. Viabilidade inclui takt e manutenção: um dispositivo mais simples que roda confiável na velocidade do ciclo ganha de um mais robusto que precisa de especialista todo mês.
-
Teste com a equipe que vai conviver com ele.
Faça um protótipo barato e rode em takt por uma ou duas semanas. Conte os disparos falsos desde o primeiro dia: um dispositivo que trava peça boa ensina a área a ignorá-lo, e dispositivo ignorado é pior que nenhum, porque parece proteção.
-
Comprove com dados, não com demonstração.
Compare a taxa de defeito no processo seguinte antes e depois, em volume suficiente para significar alguma coisa. Registre a taxa de disparo falso e o impacto no tempo de ciclo. O teste de aceitação é disparar sempre com uma peça padrão propositalmente ruim.
-
Escreva no trabalho padronizado e no plano de controle.
A checagem do dispositivo no início do turno entra no trabalho padronizado do operador, o dispositivo vira uma linha do plano de controle e todo disparo ganha um próximo passo combinado. Dispositivo que não está documentado deixa de ser conferido no mês em que o padrinho dele muda de cargo.
O último passo decide se o dispositivo ainda vai estar funcionando daqui a um ano. A checagem com a peça padrão entra no trabalho padronizado do operador, o dispositivo entra no plano de controle, e os dois entram nas auditorias escalonadas de processo, porque dispositivo que ninguém verifica não protege ninguém.
Exemplo resolvido: a estação de torque da conexão
A fabricante de componentes com 450 pessoas usada em todos estes guias, 456 unidades por dia em dois turnos e takt de 118 segundos na montagem final, vivia encontrando o mesmo defeito: uma conexão hidráulica com torque abaixo do especificado, descoberta no teste de vazamento e de vez em quando no cliente. Um caso de causa raiz já tinha gerado um padrão de torque decente, mas o escape continuava voltando mais ou menos uma vez por semana, porque o erro que sobrou não era falta de conhecimento. Cada unidade leva seis conexões e, na correria, a sexta junta às vezes recebia a parafusadeira, mas não o ciclo completo. Os números são ilustrativos; o padrão não é.
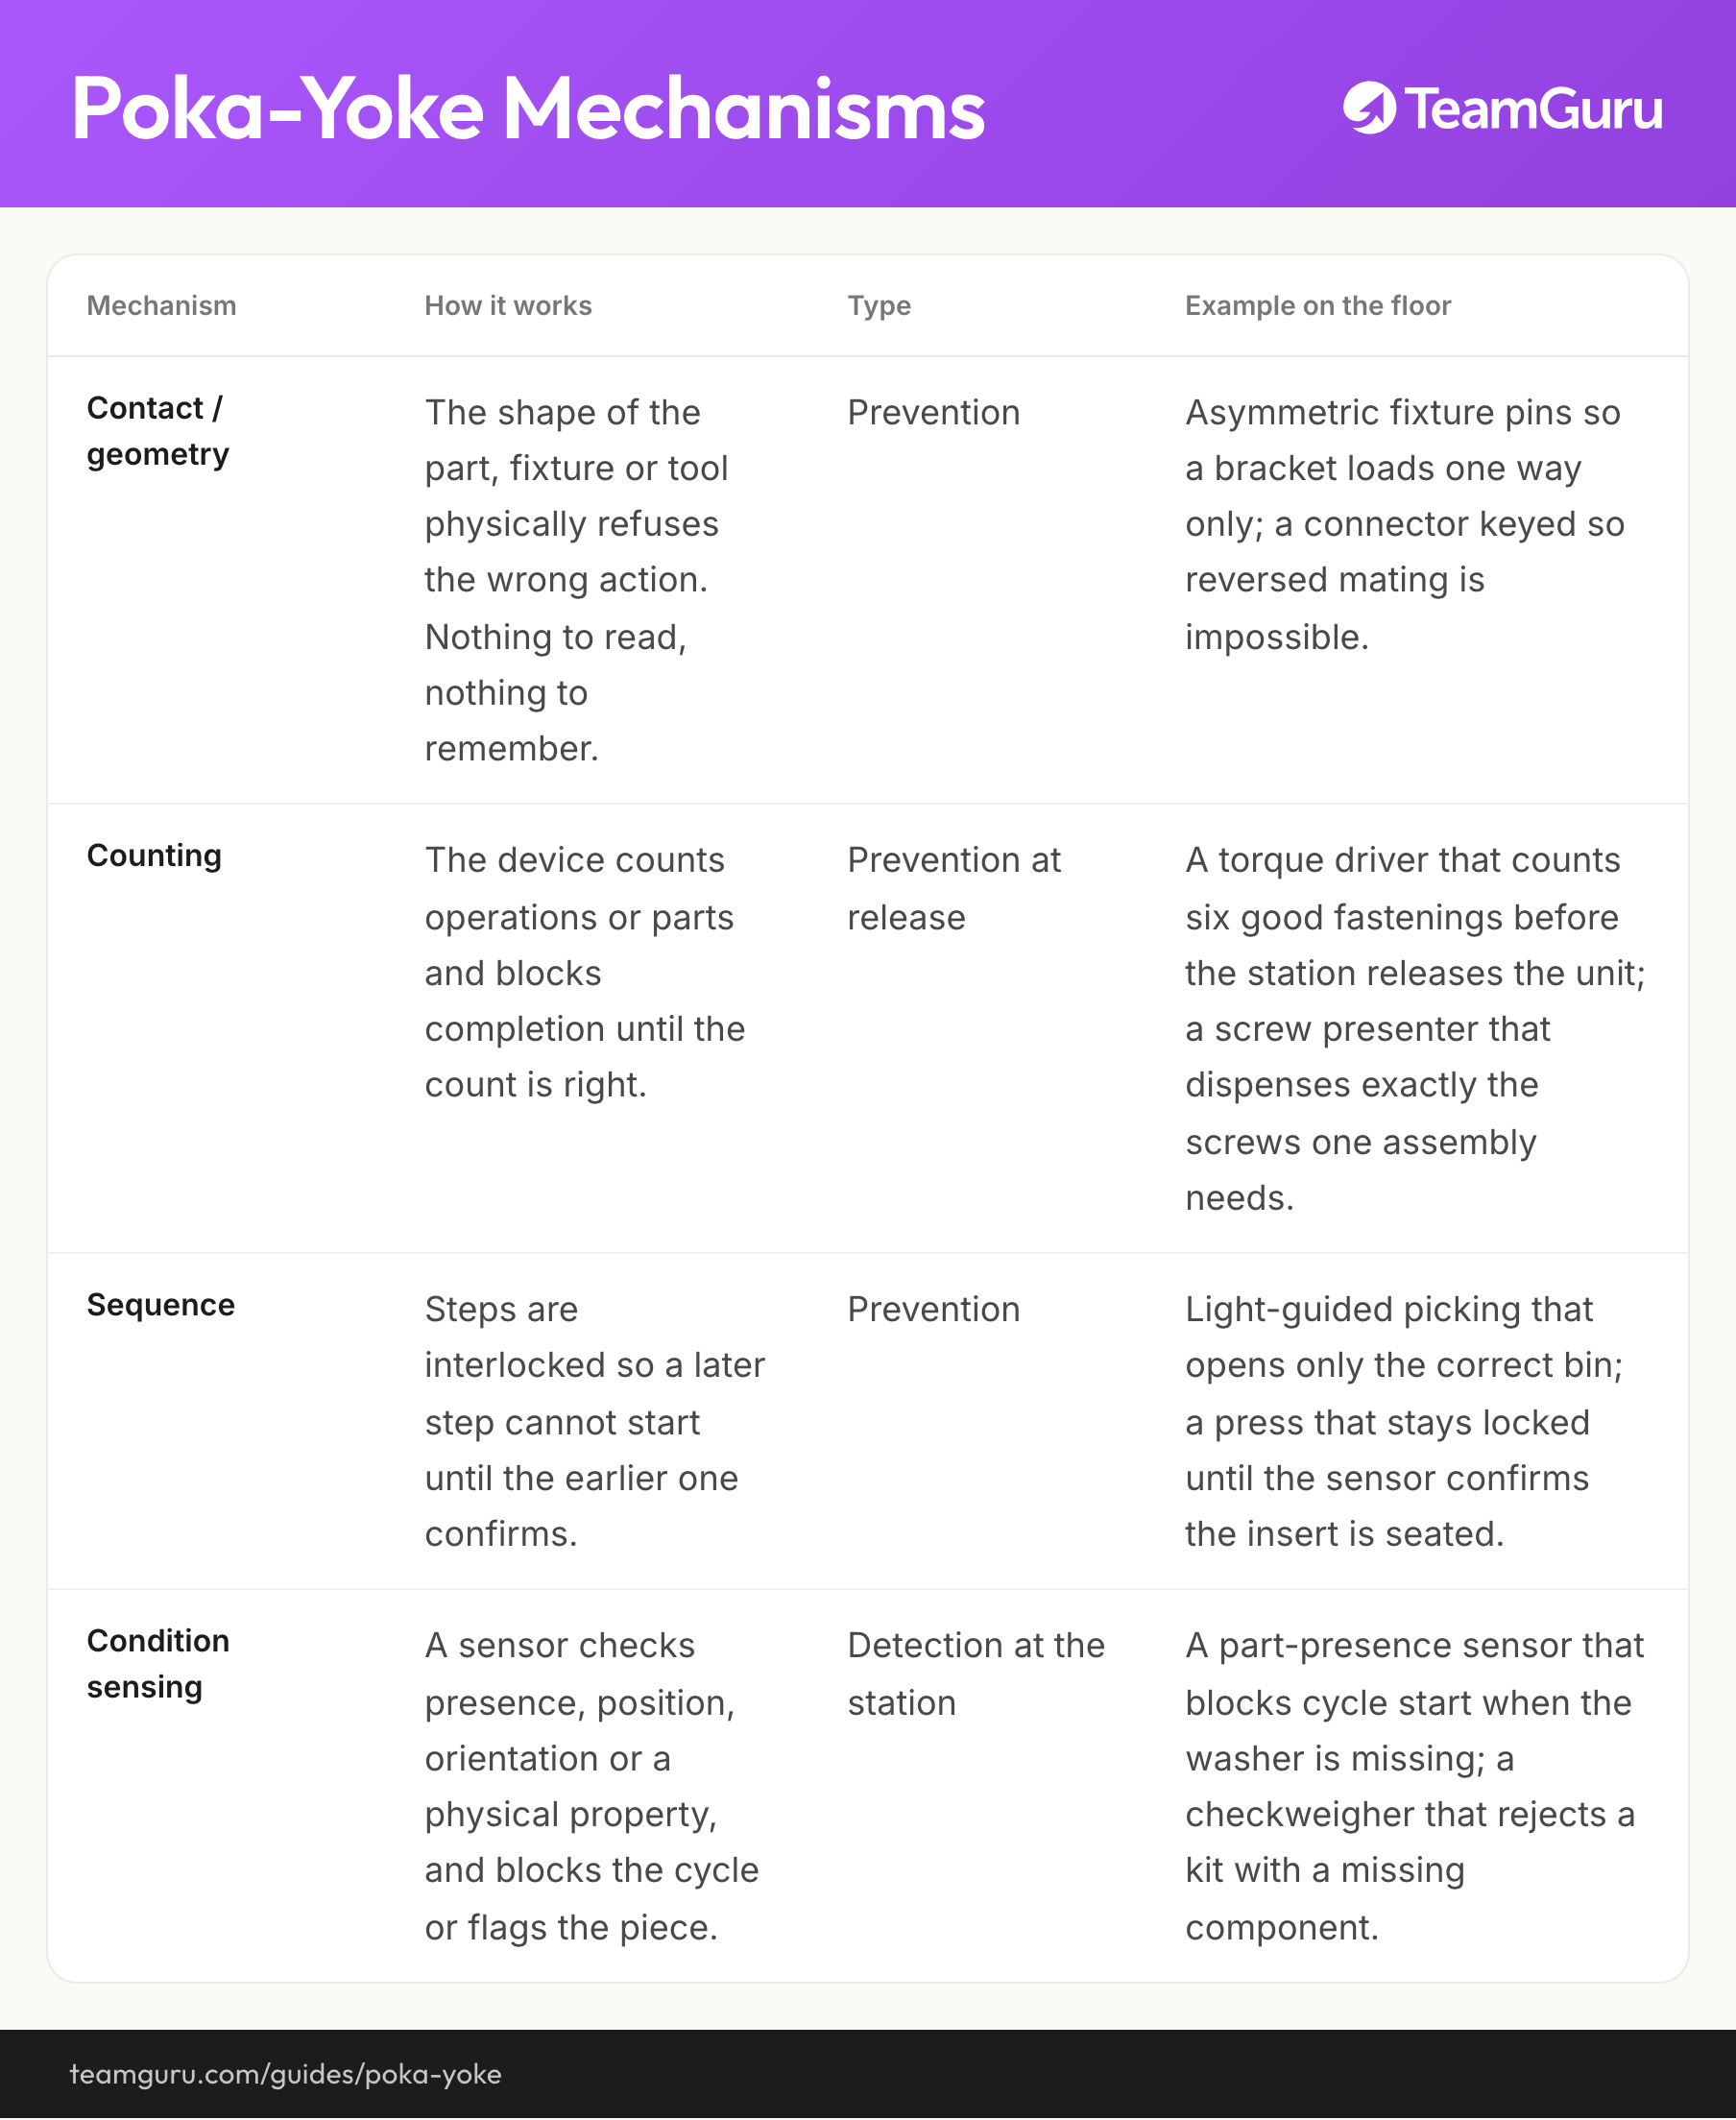
A contramedida foi uma parafusadeira com transdutor e verificação por contagem, um dispositivo de contagem da tabela de mecanismos abaixo. A parafusadeira conta os ciclos de torque bons e a bancada segura a unidade até registrar seis sinais OK; junta faltante ou incompleta acende a estação e bloqueia a liberação, tudo dentro dos 118 segundos de ciclo. O teste de duas semanas revelou um problema real de projeto: unidades de retrabalho chegavam com algumas juntas já torqueadas e causavam disparo falso, então o retrabalho ganhou um modo próprio, com liberação pelo supervisor e registro. Depois de quatro semanas de dados limpos, o escape de torque baixo no teste de vazamento foi a zero e a inspeção de contenção 100 por cento herdada do caso de causa raiz virou amostragem.
Os quatro mecanismos
Quase todo dispositivo que funciona, em produtos muito diferentes entre si, é uma variação de quatro mecanismos. As famílias importam porque servem de checklist de projeto: quando a equipe empaca em como tornar um passo à prova de erros, percorrer essas quatro costuma render dois ou três candidatos.
| Mecanismo | Como funciona | Tipo | Exemplo no chão de fábrica |
|---|---|---|---|
| Contato / geometria | O formato da peça, do dispositivo ou da ferramenta recusa fisicamente a ação errada. Nada para ler, nada para lembrar. | Prevenção | Pinos assimétricos no dispositivo, de modo que o suporte só entra de um jeito; conector com chaveamento que impossibilita inverter o encaixe. |
| Contagem | O dispositivo conta operações ou peças e trava a conclusão enquanto a contagem não fecha. | Prevenção na liberação | Parafusadeira que conta seis apertos bons antes de a estação liberar a unidade; dosador que entrega exatamente os parafusos de uma montagem. |
| Sequência | Os passos são intertravados: o passo seguinte não começa enquanto o anterior não confirma. | Prevenção | Separação guiada por luz que só abre a caixa certa; prensa que permanece travada até o sensor confirmar que o inserto está assentado. |
| Leitura de condição | Um sensor verifica presença, posição, orientação ou uma propriedade física e trava o ciclo ou sinaliza a peça. | Detecção na estação | Sensor de presença de peça que impede o início do ciclo quando falta a arruela; balança verificadora que rejeita o kit com componente faltando. |
A terceira coluna é a que vale discutir nas análises de projeto. Para qualquer dispositivo candidato, pergunte o que ele faz no instante em que o erro ocorre: torna impossível, trava a peça ou só gera um registro. Registro serve para melhorar; só os dois primeiros protegem o cliente.
A hierarquia de eficácia
Quando um modo de erro comprovado pede contramedida, desça esta escada e pare no nível mais alto que a viabilidade permitir. Cada degrau abaixo significa um retorno mais lento e uma garantia mais fraca.
-
Eliminar o passo
PrevençãoA oportunidade some: a junta vira uma conformação da própria peça, o lançamento manual vira leitura de código, a peça chega pré-montada. Sem passo, sem erro.
-
Tornar o erro impossível
PrevençãoGeometria, chaveamento e intertravamento recusam fisicamente a ação errada. A peça invertida não entra; a prensa não cicla enquanto a proteção não fecha.
-
Tornar o erro evidente na estação
Detecção na estaçãoO engano ainda acontece, mas o dispositivo trava a peça ou acende a bancada dentro do ciclo, e o erro é corrigido onde e quando foi cometido.
-
Detectar no processo seguinte
Detecção tardiaO processo de baixo pega o problema, minutos ou horas depois. O defeito já andou, a pista esfriou e começa a seleção de peças.
-
Inspecionar no fim
Detecção tardiaA inspeção final filtra o que o processo produziu. Pega bastante coisa, não prova nada sobre a causa e cobra a conta todo turno, para sempre.
-
Avisar e treinar
AdministrativoEtiquetas, placas e registros de treinamento. Servem de apoio em volta de um dispositivo; como única barreira, são um plano documentado para culpar quem estiver ali quando o inevitável acontecer.
Os dois últimos níveis não são à prova de erros coisa nenhuma. São o que o processo tem enquanto espera por um dispositivo, e o jeito honesto de usar a escada é tratar todo modo de erro hoje protegido só pelo nível 5 ou 6 como pendência na lista de melhorias.
Barato ganha do engenhoso
Um conjunto maduro de poka-yokes impressiona pouco numa visita à fábrica: pinos, guias, gabaritos, contadores, fins de curso. E isso é justamente o ponto. Um pino assimétrico de R$ 200 que torna impossível montar errado ganha de um sistema de visão que ninguém mantém, e vale dizer por quê: o pino não tem deriva, não depende de iluminação, não tem parâmetro nem especialista. Quando quebra, quebra à vista. Detecção complexa falha calada, e dispositivo que falhou calado é pior que nenhum, porque a área acredita estar protegida.
O outro motivo pelo qual o barato ganha é quem consegue projetá-lo. O operador sabe onde estão as armadilhas: quais duas etiquetas parecem iguais às três da manhã, qual peça quase entra invertida, qual passo é pulado quando a linha está atrasada. Faça do trabalho à prova de erros uma trilha permanente do kaizen: uma ideia à prova de erros por equipe por mês, construída pela própria equipe com a manutenção, custa pouco e vai tirando armadilhas que projeto de investimento nenhum alcançaria.
O que os bons dispositivos têm em comum
- Não acrescenta movimento e quase não acrescenta segundos: com takt de 118 segundos, um dispositivo que custa três segundos por ciclo estará burlado até quinta-feira.
- Falha de forma segura: quando o próprio dispositivo morre, a estação para em vez de liberar peça não verificada.
- Dá para testar em um minuto com uma peça padrão reconhecidamente ruim, então a checagem de início de turno de fato acontece.
- Todo mundo na área entende: equipe que não sabe explicar o que ele verifica não percebe quando ele para de verificar.
- Barato o bastante para copiar, para a segunda e a terceira estações não dependerem do ciclo de orçamento.
Onde isso costuma falhar
A falha clássica do poka-yoke é o dispositivo burlado, e a reação clássica trata isso como problema de disciplina. Leia primeiro como retorno da linha: dispositivo burlado quase sempre custa segundos que o takt não tem, ou dá alarme falso em peça boa. Ninguém burla uma proteção que funciona e não custa nada a quem opera. Conserte o projeto e depois, se ainda sobrar assunto, fale de disciplina.
Como é quando vai mal
- Dispositivos burlados com fita, jumper ou uma senha de liberação que todo mundo sabe, porque atrasam o ciclo
- Alarmes tão frequentes que a área aprendeu a trabalhar apesar do barulho
- O disparo não tem próximo passo combinado, e a peça sinalizada volta para o fluxo
- Ninguém verifica os dispositivos, então um sensor morto deixa passar defeito por semanas
- O trabalho à prova de erros vive como lista de pedidos de investimento, esperando o orçamento do ano que vem
Como é quando vai bem
- O dispositivo trava a peça dentro do ciclo, na estação que produziu o erro
- Todo disparo tem plano de reação: conter a peça, registrar, definir quem decide
- A checagem com peça padrão no início do turno prova que o dispositivo ainda dispara
- A taxa de disparo falso é acompanhada e puxada para perto de zero já no primeiro mês
- O próximo dispositivo mira o principal modo de escape da lista de prioridades do FMEA
Depois do dispositivo: encolher a inspeção
Um dispositivo com dados limpos muda a conta de tudo que vem depois. Inspeções de contenção instaladas no meio do incêndio podem virar amostragem, a inspeção final encolhe na direção de uma auditoria, e refugo e retrabalho param de comer os indicadores de qualidade da linha de base enquanto o fator qualidade do OEE se recupera. É esse o retorno que a hierarquia promete: prevenção se paga uma vez e continua rendendo, enquanto a inspeção cobra a conta todo turno.
O que sobra é a cadeia de gestão em volta dos disparos. Um dispositivo que trava a peça fez metade do trabalho; alguém ainda precisa conter a peça, decidir o destino dela e perceber que o mesmo modo de erro disparou nove vezes neste mês, o que é tarefa de solução de problemas e não linha de caderno. É aqui que o TeamGuru encaixa naturalmente: o caso de uso de gestão de alertas de qualidade dá a cada dispositivo disparado um fluxo de reação, com o alerta aberto na estação, contenção e destino nas mãos de responsáveis com prazo, e disparos repetidos visíveis o bastante para exigir um caso de causa raiz.
No roadmap, o trabalho à prova de erros segue rodando dentro da prática de equipamentos e métodos à medida que o FMEA gera novas prioridades, em paralelo com o funil de Kaizen, e os resultados chegam à Obeya e às análises críticas pela direção da fábrica como menos escapes e um custo da má qualidade em queda.
Leve com você
O diagrama deste guia como imagem, livre para usar em treinamentos e workshops internos.
Baixar PNGPerguntas frequentes
O que quer dizer Poka-Yoke?
Qual a diferença entre poka-yoke de prevenção e de detecção?
Quais são exemplos de poka-yoke na montagem?
Quanto custa um dispositivo poka-yoke?
Quem deve projetar os dispositivos poka-yoke?
O que fazer quando um poka-yoke dispara?
Como funciona no TeamGuru