Guía de implementación
Poka-Yoke: a prueba de errores.
El poka-yoke es la práctica lean de hacer un proceso a prueba de errores: la equivocación humana no puede ocurrir o se vuelve visible en cuanto ocurre, en la estación. Ataca al error, no al operador: donde una equivocación es posible, bastantes turnos acabarán produciéndola. Los buenos dispositivos son simples, caben en el ciclo y superan a la inspección final y a un registro más de capacitación. Prevenir supera a detectar; detectar en la estación supera a inspeccionar al final.
Qué es el poka-yoke
Poka-yoke significa en japonés evitar equivocaciones inadvertidas, y en manufactura nombra una disciplina de diseño concreta: cambiar la pieza, el dispositivo de sujeción, la herramienta o la secuencia para que una equivocación humana o bien no pueda ocurrir físicamente, o bien se vuelva visible dentro del mismo ciclo, en la estación donde ocurrió. Un conector polarizado que no se puede acoplar al revés es poka-yoke. También lo es un atornillador que cuenta aprietes y se niega a liberar la unidad hasta que cada unión reporta un ciclo bueno.
El razonamiento viene de Shigeo Shingo y del Sistema de Producción Toyota, y se apoya en una distinción que la mayoría de los sistemas de calidad difumina: un error no es un defecto. Los errores, un paso saltado, una pieza invertida, una toma equivocada, son un resultado normal de la atención humana en trabajo repetitivo. Los defectos son errores a los que se les permitió viajar. La inspección acepta el vínculo entre ambos e intenta filtrar el resultado. El poka-yoke rompe el vínculo.
Por eso el objetivo honesto es el error, no el operador. Con 456 unidades por día, un modo de error con una probabilidad de uno entre diez mil por ciclo aparecerá cada tres semanas aproximadamente, para siempre, sin importar quién esté de turno. Una etiqueta de advertencia y un registro de capacitación no cambian esa aritmética. Un perno de sujeción sí. Donde una equivocación es posible, bastantes turnos acabarán produciéndola, así que las opciones reales son tres: hacerla imposible, hacerla visible de inmediato, o planear encontrarla en el cliente, para siempre.
Dónde encaja el poka-yoke en la hoja de ruta de transformación
En la hoja de ruta de despliegue de TeamGuru, la prevención de errores pertenece a la práctica de equipos y métodos de la etapa «Mejorar», junto a SMED y TPM. Es una disciplina de contramedidas, lo que significa que necesita una lista de objetivos: las filas prioritarias de un AMEF vivo y las causas verificadas que vuelven una y otra vez en los casos de análisis de causa raíz y acciones correctivas son el origen de los buenos proyectos de poka-yoke. Un dispositivo construido sin ese trabajo previo es una suposición con un sensor pegado.
- Antes Gestión diaria
- Está aquí SMED, TPM, AMEF y Poka-Yoke
- En paralelo Kaizen
- Después Obeya y revisión por la dirección
Cuándo no aplicar poka-yoke
La prevención de errores merece una parte grande de cualquier presupuesto de calidad, y justo por eso necesita criterios para decir todavía no. No construya un dispositivo cuando:
- No puede describir cómo ocurre realmente el error. Si el equipo no ha visto ocurrir la equivocación, ni la ha reproducido, el dispositivo bloqueará una suposición. Automatizar una teoría equivocada produce una estación más incómoda de usar y exactamente igual de desprotegida que antes.
- El riesgo es trivial mientras el defecto principal sigue abierto. Adornar con sensores un modo de error cosmético mientras el escape número uno al cliente no tiene barrera es un error de prioridades. Ordene primero los modos de error por consecuencia e historial de escapes, y luego trabaje la lista.
- El paso simplemente se puede eliminar. Si una unión atornillada puede convertirse en un rasgo conformado, o una captura manual en un escaneo de código de barras, quitar la oportunidad gana a protegerla. Eliminar está en lo alto de la jerarquía de más abajo, y se revisa primero.
Cómo implementar un dispositivo
Un modo de error a la vez, en el proceso, con el equipo. La secuencia:
-
Elija el escape principal.
Tómelo de la lista de prioridades del AMEF, de las causas raíz que se repiten y del historial de quejas de cliente, no de donde resulte más fácil montar un sensor. Un modo de error, una estación, un dispositivo. Un programa de prevención de errores lanzado a la vez en toda la planta produce sobre todo reuniones.
-
Estudie cómo ocurre realmente el error.
Observe ciclos reales en la estación, incluidos el fin de turno, el cambio de modelo y el retrabajo, porque ahí es donde se concentran los errores. Pregunte a los operadores dónde están las trampas; casi siempre saben nombrar el casi accidente que atrapan cada semana. Escriba el mecanismo del error en una sola frase antes de diseñar nada.
-
Elija el nivel más alto de la jerarquía que sea viable.
Prevenir supera a detectar, detectar en la estación supera a detectar aguas abajo, y todo supera a la inspección final. La viabilidad incluye el takt y el mantenimiento: un dispositivo más simple que funciona de forma confiable a la velocidad del ciclo supera a uno más potente que necesita un especialista cada mes.
-
Pruébelo con el equipo que va a convivir con él.
Haga un prototipo barato y déjelo correr al takt una o dos semanas. Cuente los disparos falsos desde el primer día: un dispositivo que marca piezas buenas le enseña al área a ignorarlo, y un dispositivo ignorado es peor que ninguno, porque parece protección.
-
Verifique con datos, no con una demostración.
Compare la tasa de defectos aguas abajo antes y después, sobre volumen suficiente para que signifique algo. Registre la tasa de disparos falsos y el impacto en el tiempo de ciclo. La prueba de aceptación es que dispare de forma confiable con una pieza patrón deliberadamente mala.
-
Escríbalo en el trabajo estandarizado y en el plan de control.
La verificación del dispositivo al inicio de turno entra en el trabajo estandarizado del operador, el dispositivo se convierte en una línea del plan de control y cada disparo recibe un siguiente paso acordado. Un dispositivo sin documentar deja de verificarse el mes en que su promotor cambia de puesto.
El último paso decide si el dispositivo sigue funcionando dentro de un año. La verificación con pieza patrón pertenece al trabajo estandarizado del operador, el dispositivo pertenece al plan de control, y ambos pertenecen a las auditorías de proceso por capas, porque un dispositivo que nadie verifica no protege a nadie.
Ejemplo resuelto: la estación de apriete de conexiones
El fabricante de componentes de 450 personas que usamos en todas estas guías, 456 unidades por día en dos turnos y un takt de 118 segundos en ensamble final, se topaba una y otra vez con el mismo defecto: una conexión hidráulica con apriete insuficiente detectada en la prueba de fugas y, en ocasiones, en el cliente. Un caso de causa raíz ya había producido un estándar de par correcto, pero el escape seguía regresando una vez por semana aproximadamente, porque el error residual no era de conocimiento. Cada unidad lleva seis conexiones y, bajo presión de tiempo, la sexta unión a veces recibía la pistola pero no el ciclo completo. Las cifras son ilustrativas; el patrón no.
La contramedida fue un atornillador con transductor y verificación por conteo, un dispositivo de conteo de la tabla de mecanismos de más abajo. El atornillador cuenta los ciclos de par buenos y la estación retiene la unidad hasta que se registran seis señales OK; una unión omitida o incompleta hace que la estación se encienda y bloquee la liberación, todo dentro del ciclo de 118 segundos. La prueba de dos semanas sacó a la luz un problema real de diseño: las unidades de retrabajo que llegaban con algunas uniones ya apretadas provocaban disparos falsos, así que el retrabajo recibió su propio modo, con liberación por el supervisor y un registro en la bitácora. Tras cuatro semanas de datos limpios, el escape por apriete insuficiente en la prueba de fugas bajó a cero y la verificación de contención al 100 por ciento heredada del caso de causa raíz se redujo a un muestreo.
Los cuatro mecanismos
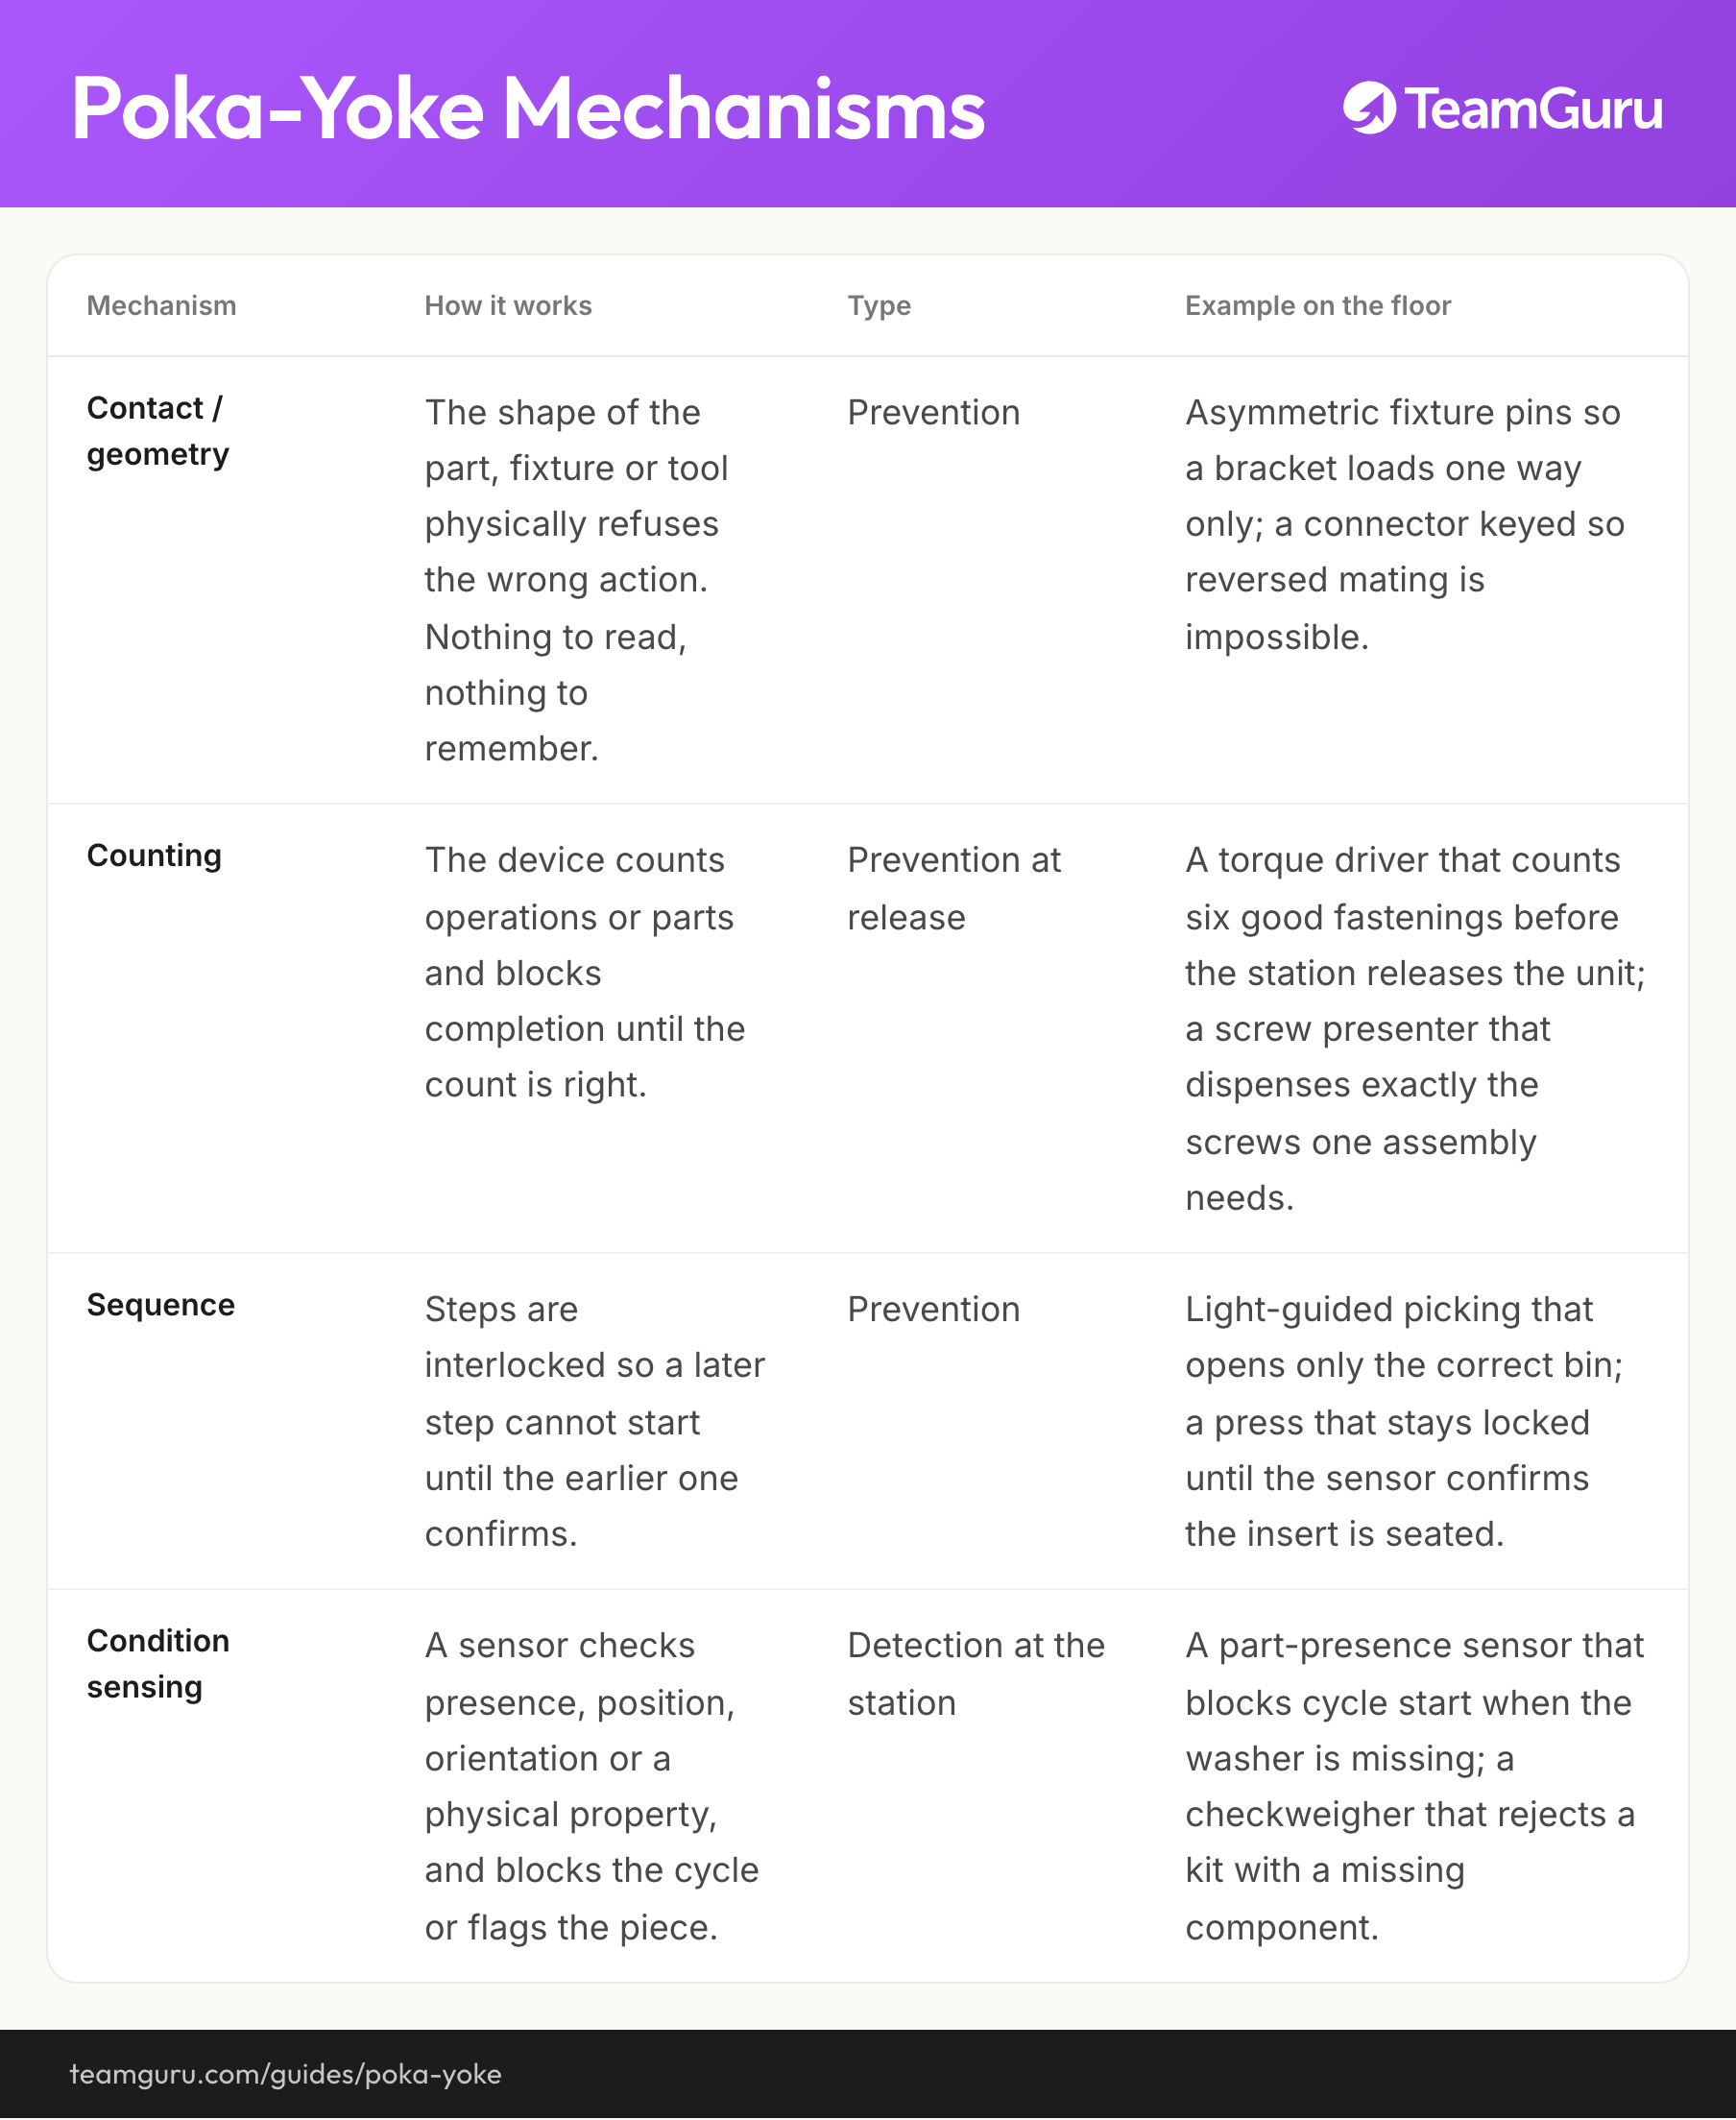
La mayoría de los dispositivos que funcionan, en productos muy distintos entre sí, son variaciones de cuatro mecanismos. Las familias importan porque son una lista de verificación de diseño: cuando un equipo se atora en cómo hacer un paso a prueba de errores, recorrer estos cuatro suele producir dos o tres candidatos.
| Mecanismo | Cómo funciona | Tipo | Ejemplo en el piso de producción |
|---|---|---|---|
| Contacto / geometría | La forma de la pieza, del dispositivo de sujeción o de la herramienta rechaza físicamente la acción incorrecta. Nada que leer, nada que recordar. | Prevención | Pernos de sujeción asimétricos para que una ménsula solo entre en una posición; un conector polarizado que no permite el acoplamiento invertido. |
| Conteo | El dispositivo cuenta operaciones o piezas y bloquea el cierre hasta que la cuenta es correcta. | Prevención al liberar | Un atornillador que cuenta seis aprietes buenos antes de que la estación libere la unidad; un dosificador que entrega exactamente los tornillos que necesita un ensamble. |
| Secuencia | Los pasos están enclavados: un paso posterior no puede empezar hasta que el anterior confirma. | Prevención | Estantes pick-to-light que solo abren el contenedor correcto; una prensa que permanece bloqueada hasta que el sensor confirma que el inserto está asentado. |
| Detección de condición | Un sensor comprueba presencia, posición, orientación o una propiedad física, y bloquea el ciclo o marca la pieza. | Detección en la estación | Un sensor de presencia de pieza que bloquea el arranque del ciclo cuando falta la rondana; una báscula de control que rechaza un kit al que le falta un componente. |
La tercera columna es la que hay que discutir en las revisiones de diseño. Para cualquier dispositivo candidato, pregunte qué hace en el momento en que ocurre el error: lo hace imposible, detiene la pieza, o solo escribe un registro. Los registros sirven para mejorar; solo los dos primeros protegen al cliente.
La jerarquía de eficacia
Cuando un modo de error verificado necesita una contramedida, baje por esta escalera y deténgase en el nivel más alto que permita la viabilidad. Cada escalón hacia abajo significa un ciclo de retroalimentación más largo y una garantía más débil.
-
Eliminar el paso
PrevenciónLa oportunidad desaparece: la unión atornillada se convierte en un rasgo conformado, la captura manual pasa a ser un escaneo, la pieza llega preensamblada. Sin paso no hay error.
-
Hacer imposible el error
PrevenciónLa geometría, la polarización y los enclavamientos rechazan físicamente la acción incorrecta. La pieza al revés no entra; la prensa no cicla hasta que la guarda se cierra.
-
Hacer el error evidente en la estación
Detección en la estaciónLa equivocación sigue ocurriendo, pero el dispositivo detiene la pieza o enciende la estación dentro del ciclo, y el error se corrige donde y cuando se cometió.
-
Detectar aguas abajo
Detección tardíaEl proceso siguiente lo atrapa, minutos u horas después. El defecto ya viajó, la pista está fría y empieza la selección de piezas.
-
Inspeccionar al final
Detección tardíaLa inspección final filtra lo que el proceso produjo. Atrapa mucho, no prueba nada sobre la causa y le pasa factura cada turno, para siempre.
-
Advertir y capacitar
AdministrativoEtiquetas, letreros y registros de capacitación. Son útiles como apoyo alrededor de un dispositivo; como única barrera, son un plan documentado para culpar a quien esté parado ahí cuando ocurra lo inevitable.
Los dos niveles de abajo no son prevención de errores en absoluto. Son lo que tiene un proceso mientras espera un dispositivo, y la forma honesta de usar la escalera es tratar cada modo de error protegido hoy solo por el nivel 5 o el 6 como un punto abierto en la lista de mejora.
Lo barato gana a lo ingenioso
Un conjunto maduro de sistemas a prueba de errores se ve poco impresionante en un recorrido por la planta: pernos, guías, plantillas, contadores, finales de carrera. Eso es una virtud. Un perno asimétrico de 40 dólares que hace imposible cargar la pieza al revés gana a un sistema de visión que nadie mantiene, y vale la pena decir por qué: el perno no tiene deriva, no depende de la iluminación, no tiene parámetros y no necesita un especialista. Cuando se rompe, se rompe a la vista. La detección compleja falla en silencio, y un dispositivo que falló en silencio es peor que ninguno, porque el área se cree protegida.
La otra razón por la que gana lo barato es quién puede diseñarlo. Los operadores saben dónde están las trampas: qué dos etiquetas se parecen a las 03:00, qué pieza casi entra al revés, qué paso se salta cuando la línea va atrasada. Convierta la prevención de errores en un tema fijo de kaizen: una idea de prevención de errores por equipo y por mes, construida por el equipo junto con mantenimiento, cuesta poco y elimina de forma constante trampas a las que ningún proyecto de inversión llegaría nunca.
Qué tienen en común los buenos dispositivos
- No añaden movimiento y casi no añaden segundos: con un takt de 118 segundos, un dispositivo que cuesta tres segundos por ciclo estará burlado para el jueves.
- Fallan de forma segura: cuando el propio dispositivo muere, la estación se detiene en lugar de dejar pasar piezas sin verificar.
- Se pueden probar en un minuto con una pieza patrón defectuosa conocida, para que la verificación de inicio de turno de verdad ocurra.
- Los entiende todo el mundo en el área: un equipo que no puede explicar qué verifica el dispositivo tampoco puede notar cuándo dejó de verificar.
- Son lo bastante baratos como para copiarlos, de modo que la segunda y la tercera estación no necesitan un ciclo de presupuesto.
Dónde falla en la práctica
El fracaso clásico del poka-yoke es el dispositivo burlado, y la respuesta clásica lo lee como un problema de disciplina. Léalo primero como retroalimentación: un dispositivo burlado casi siempre cuesta segundos que el takt no tiene, o da falsas alarmas con piezas buenas. La gente no burla una protección que funciona y que no le cuesta nada. Corrija el diseño y después hable de disciplina, si queda algo que discutir.
Así se ve mal
- Dispositivos burlados con cinta, puentes o un código de anulación compartido porque alargan el ciclo
- Alarmas tan frecuentes que el área ha aprendido a convivir con el ruido
- Disparos sin un siguiente paso acordado, así que las piezas marcadas regresan al flujo
- Nadie verifica los dispositivos, así que un sensor muerto deja pasar defectos durante semanas
- La prevención de errores vive como una lista de solicitudes de inversión, esperando el presupuesto del año que viene
Así se ve bien
- El dispositivo detiene la pieza dentro del ciclo, en la estación que la produjo
- Cada disparo tiene un plan de reacción: contener la pieza, registrarla, nombrar a quien decide
- Una verificación con pieza patrón al inicio de turno demuestra que el dispositivo sigue disparando
- La tasa de disparos falsos se mide y se lleva casi a cero en el primer mes
- El siguiente dispositivo apunta al escape principal de la lista de prioridades del AMEF
Después del dispositivo: reducir la inspección
Un dispositivo con datos limpios cambia la aritmética aguas abajo. Las verificaciones de contención instaladas durante el apagado de incendios pueden bajar a muestreo, la inspección final se reduce a una auditoría, y el scrap y el retrabajo dejan de gravar las métricas de calidad de la línea base de KPIs mientras el factor de calidad del OEE (eficiencia general de los equipos) se recupera. Este es el beneficio que promete la jerarquía: la prevención se paga una vez y sigue rindiendo, mientras que la inspección pasa factura cada turno.
Lo que queda es la cadena de gestión alrededor de los disparos. Un dispositivo que detiene una pieza ha hecho la mitad del trabajo; alguien todavía tiene que contener la pieza, decidir su disposición y notar que el mismo modo de error se ha disparado nueve veces este mes, que es trabajo para un caso de resolución de problemas y no una línea de bitácora. Aquí es donde TeamGuru encaja de forma natural: el caso de uso de gestión de alertas de calidad da a cada dispositivo disparado un flujo de reacción, con la alerta levantada en la estación, la contención y la disposición a cargo de responsables con fechas, y los disparos repetidos lo bastante visibles como para exigir un caso de causa raíz.
En la hoja de ruta, la prevención de errores sigue corriendo dentro de la práctica de equipos y métodos a medida que el AMEF produce nuevas prioridades, en paralelo con el flujo de kaizen, y sus resultados llegan a la Obeya y a las revisiones por la dirección de la planta como menos escapes y un costo de la mala calidad a la baja.
Lléveselo consigo
El diagrama de esta guía como imagen, de uso libre en formaciones internas y talleres.
Descargar PNGPreguntas frecuentes
¿Qué significa poka-yoke?
¿Cuál es la diferencia entre poka-yoke de prevención y de detección?
¿Qué ejemplos de poka-yoke hay en ensamble?
¿Cuánto cuesta un dispositivo poka-yoke?
¿Quién debe diseñar los dispositivos poka-yoke?
¿Qué pasa cuando un dispositivo poka-yoke se dispara?
Cómo lo lleva a la práctica TeamGuru