Guía de implementación
Mantenimiento productivo total (TPM).
El mantenimiento productivo total (TPM) es un sistema para eliminar las pérdidas de los equipos: pone el cuidado diario de la máquina en manos de quien la opera, con el respaldo del mantenimiento planificado e ingeniería. Cuando los operadores limpian, inspeccionan y lubrican su equipo, el deterioro se detecta a tiempo y las averías dejan de ser azar y pasan a ser decisiones. Empiece por el mantenimiento autónomo en la máquina cuello de botella, no por ocho pilares en un cartel.
Qué es el TPM y para qué sirve
El mantenimiento productivo total (total productive maintenance) es un sistema para eliminar las pérdidas de los equipos: averías, paros menores, pérdidas de velocidad y defectos causados por el estado de la máquina. Se apoya en tres frentes. El mantenimiento autónomo pone el cuidado diario, limpiar, inspeccionar, lubricar y apretar, en manos de los operadores que hacen andar la máquina. El mantenimiento planificado da al equipo profesional de mantenimiento un programa gobernado por la condición y la criticidad, y no por quien grita más fuerte. La mejora enfocada ataca de una en una las mayores pérdidas registradas, con un equipo multidisciplinario.
El modelo clásico envuelve todo esto en ocho pilares y añade mantenimiento de calidad, gestión temprana del equipo, educación y entrenamiento, seguridad y medio ambiente, y TPM administrativo. Mencione los pilares una vez y guarde el cartel. Lanzar ocho programas paralelos con subcomités es la forma de que el TPM se convierta en una burocracia que nunca toca una máquina. Mantenimiento autónomo más mantenimiento planificado más mejora enfocada aportan casi todo el valor; un 90 por ciento es una cifra de trabajo razonable. Los pilares restantes solo tienen sentido cuando esos tres ya funcionan a la vista de todos.
Que el pilar decisivo sea la responsabilidad del operador tiene una razón mecánica, no cultural. Las averías casi nunca llegan de golpe: se incuban. Un rodamiento se queda sin lubricante, un tornillo se afloja, la viruta se acumula en una guía y, durante semanas, la máquina lo anuncia con ruido, calor, vibración y fugas. Los únicos que pueden oír ese aviso todos los días son los operadores. Cuando limpian la máquina, la tocan; cuando la tocan, descubren qué se afloja y qué gotea; y cuando ese hallazgo dispara una corrección, las averías dejan de ser el mal tiempo que le cae a la planta y pasan a ser decisiones que alguien tomó o no tomó.
Dónde encaja el TPM en la hoja de ruta de transformación
El TPM pertenece a la práctica de métodos de equipo en la etapa Mejorar de la hoja de ruta de despliegue, junto con SMED, AMEF y poka-yoke. La ubicación es deliberada: el TPM rinde donde la gestión diaria ya sostiene los avances y produce números honestos. Los tableros diarios registran el tiempo de paro por causa en cada turno, y las pérdidas de disponibilidad que hay dentro de la captura de OEE señalan las máquinas y los modos de falla que valen el esfuerzo. Si empieza el TPM antes de tener esos datos, elegir máquina es política; si empieza después, es aritmética.
- Antes Gestión diaria
- Está aquí SMED, TPM, AMEF y Poka-Yoke
- En paralelo Kaizen
- Después Obeya y revisiones por la dirección
Cuándo el TPM se atasca antes de empezar
La mayoría de los arranques fallidos de TPM se perdieron antes de la primera limpieza profunda, y las causas le corresponden a la dirección, no a los operadores. Revise estas tres antes de anunciar nada:
- Un rezago de mantenimiento tan profundo que los operadores solo encuentran promesas rotas. Si la máquina tiene diez defectos conocidos que mantenimiento no ha corregido en un año, un sistema de tarjetas solo documenta el número once. Liquide primero el rezago crítico de la máquina piloto, para que la limpieza profunda empiece en una máquina con sus fallas conocidas ya resueltas.
- Sin tiempo reservado para las rutinas. Si el plan de turno supone que cada minuto es producción, la rutina diaria de limpieza, inspección y lubricación es un robo, y se la saltarán el primer día de apuro y todos los siguientes. Meta esos minutos en el programa y defiéndalos.
- Sin datos de pérdidas. Sin tiempo de paro registrado por causa no hay forma de elegir la máquina correcta, no hay línea base y no habrá prueba seis meses después. Bastan unas semanas de captura honesta en el tablero diario para empezar.
Cómo implantar el mantenimiento autónomo
No empiece con un programa. Empiece con una máquina, y que sea el cuello de botella. El cuello de botella es donde las pérdidas de disponibilidad son pérdidas de producción: una hora de avería ahí es una hora de producción de toda la planta, lo que hace visible el retorno y fácil el argumento para la segunda máquina. En la planta de componentes de 450 personas que se usa como ejemplo en todo este sitio (456 piezas al día, dos turnos), esa máquina es la línea de maquinado, que pierde 33 minutos diarios por averías y otros 16 por paros menores de los 840 minutos disponibles. Esas dos filas del registro de pérdidas son el objetivo del piloto.
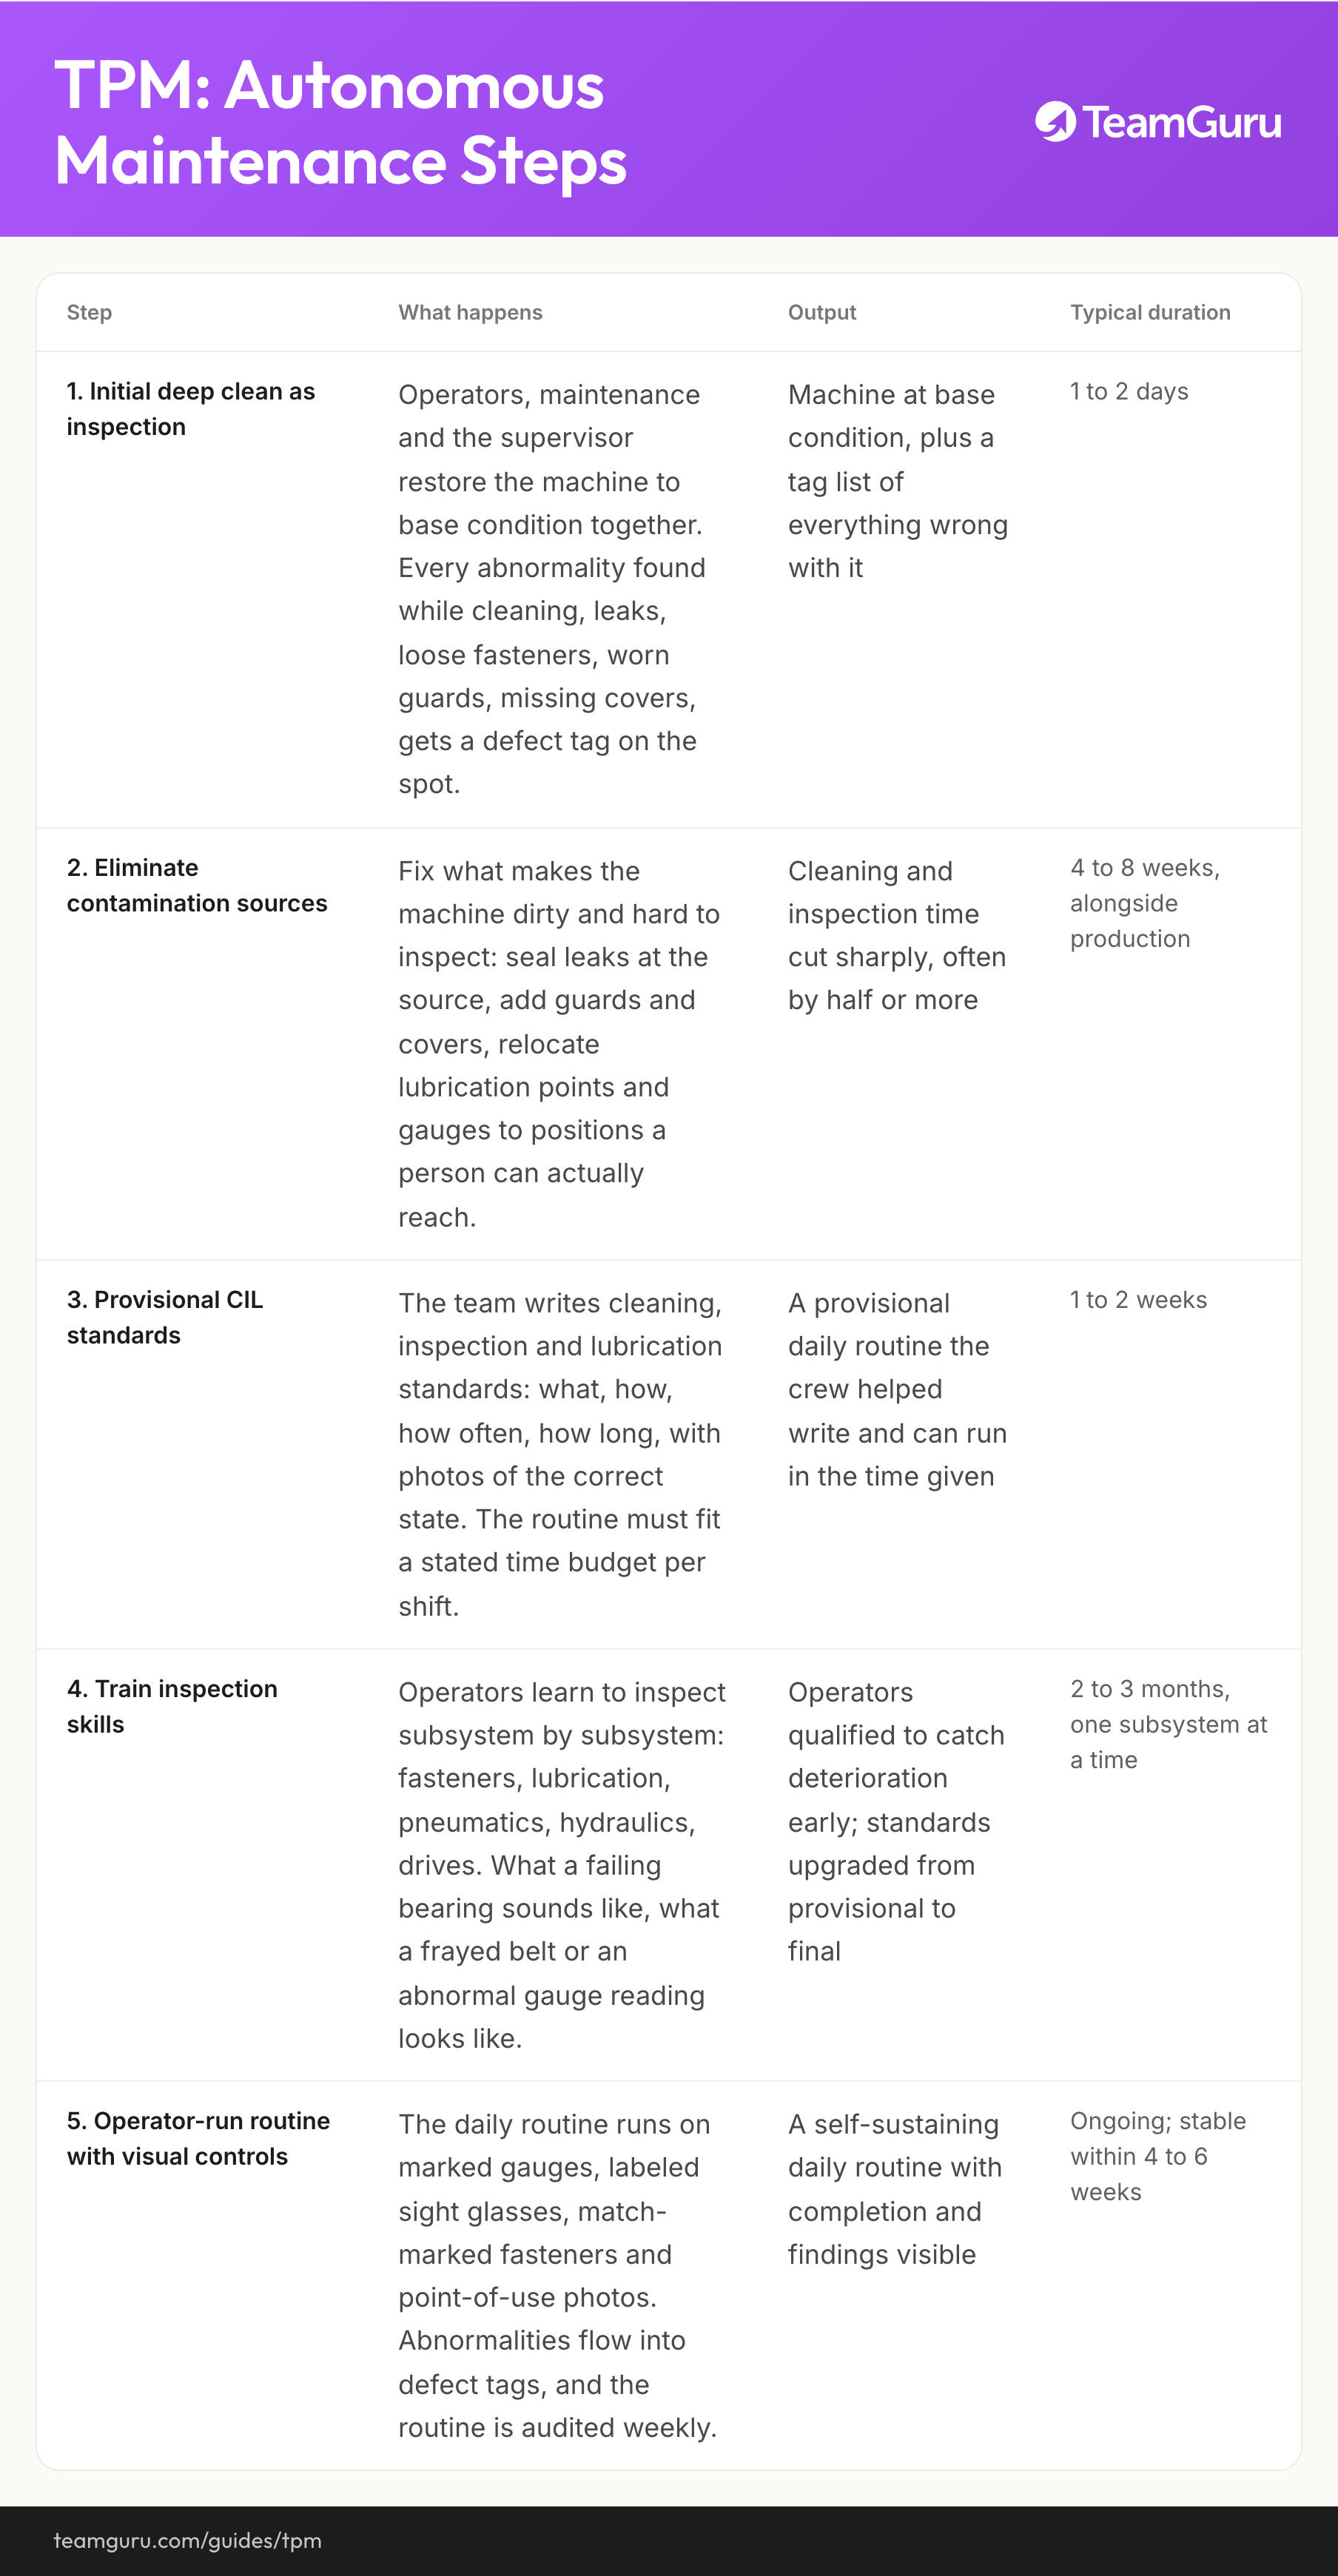
El método son los cinco pasos del mantenimiento autónomo, ejecutados en orden, con mantenimiento y el supervisor trabajando codo a codo con los operadores. Las duraciones son una orientación práctica para una máquina, no un calendario corporativo.
| Paso | Qué ocurre | Resultado | Duración típica |
|---|---|---|---|
| 1. Limpieza profunda inicial como inspección | Operadores, mantenimiento y el supervisor devuelven juntos la máquina a sus condiciones básicas. Cada anomalía que aparece al limpiar, fugas, tornillería floja, guardas desgastadas, cubiertas faltantes, recibe una tarjeta de defecto en el momento. | Máquina en condiciones básicas, más una lista con todo lo que está mal en ella | 1 a 2 días |
| 2. Eliminar las fuentes de contaminación | Corrija lo que ensucia la máquina y dificulta inspeccionarla: sellar las fugas en su origen, añadir guardas y cubiertas, reubicar puntos de lubricación e indicadores donde una persona los alcance de verdad. | El tiempo de limpieza e inspección se reduce mucho, a menudo a la mitad o menos | 4 a 8 semanas, en paralelo a la producción |
| 3. Estándares CIL provisionales | El equipo redacta los estándares de limpieza, inspección y lubricación: qué, cómo, cada cuánto, cuánto dura, con fotos del estado correcto. La rutina debe caber en el tiempo que se le asigne por turno. | Una rutina diaria provisional que los operadores ayudaron a escribir y pueden ejecutar en ese tiempo | 1 a 2 semanas |
| 4. Formar en habilidades de inspección | Los operadores aprenden a inspeccionar subsistema por subsistema: tornillería, lubricación, neumática, hidráulica, transmisiones. Cómo suena un rodamiento que empieza a fallar, cómo se ve una banda deshilachada o una lectura anormal en un indicador. | Operadores capaces de detectar el deterioro a tiempo; estándares que pasan de provisionales a definitivos | 2 a 3 meses, un subsistema a la vez |
| 5. Rutina a cargo del operador con controles visuales | La rutina diaria se apoya en indicadores con el rango marcado, mirillas etiquetadas, marcas de referencia en la tornillería y fotos en el punto de uso. Las anomalías se convierten en tarjetas de defecto y la rutina se audita cada semana. | Una rutina diaria que se sostiene sola, con cumplimiento y hallazgos a la vista | Permanente; estable en 4 a 6 semanas |
Si el área ya trabaja con 5S, el paso 1 le resultará familiar: es el paso de limpieza hecho con intención de inspeccionar, y ambas prácticas se refuerzan entre sí. El estándar CIL del paso 3 es trabajo estandarizado para el cuidado de la máquina, y vive con las mismas reglas: escrito con quienes lo ejecutan, ajustado al tiempo disponible, revisado cuando la realidad lo contradice.
Controles visuales que hacen rápida la inspección
La inspección que exige criterio se salta en un mal día. La inspección que solo exige una mirada sobrevive. Marque el rango normal de operación en cada indicador para que lo anormal se vea en un segundo, etiquete el mínimo y el máximo en las mirillas, ponga marcas de referencia en la tornillería crítica para que un tornillo flojo se delate solo, y coloque una foto del estado correcto en el punto de uso, no en una carpeta. La prueba de un buen estándar visual: un operador nuevo puede completar la rutina correctamente, y notar qué está mal, sin preguntarle a nadie.
Tarjetas de defecto: el medidor de confianza
La limpieza profunda del paso 1 saca a la luz todo lo que la máquina venía acumulando en silencio; en una máquina descuidada, cuente con decenas de tarjetas, habitualmente de 50 a 150. Lo que ocurra con esas tarjetas decide la suerte de todo el esfuerzo. Use un sistema de dos colores: un color para los defectos que los operadores pueden corregir por sí mismos, otro para mantenimiento. Cada tarjeta registra qué se encontró, dónde, quién y cuándo. Clasifíquelas cada semana con mantenimiento, cierre las rápidas en días y ponga en el tablero del área la tendencia del rezago y su edad mediana.
El rezago de tarjetas es el medidor de confianza, y se merece ese nombre. Se pide a los operadores que detecten el deterioro a cambio de una promesa de la dirección: lo que se detecta, se corrige. Si las tarjetas quedan abiertas durante meses, la promesa se rompe en público, los operadores aprenden que detectar no sirve de nada y el mantenimiento autónomo muere educadamente mientras las listas de verificación siguen en verde. Cerrar tarjetas rápido es lo que compra el compromiso para la segunda máquina. La auditoría semanal de la rutina y la revisión de tarjetas pertenecen al programa de auditorías por capas de la planta, para que el control del sistema sobreviva a las semanas cargadas.
Cómo medir si funciona
El TPM produce su propia prueba, siempre que ya se estuviera midiendo antes de arrancar el piloto. Tome la línea base de la captura que ya hace el sistema diario y luego siga la tendencia de cada máquina contra sí misma:
- Pérdidas de disponibilidad de la captura de OEE: minutos de avería y paros menores por día, por causa. En la línea de maquinado piloto la línea base ilustrativa es de 33 y 16 minutos; la fila de averías es el primer objetivo.
- MTBF, el tiempo medio entre fallas, seguido por máquina. Importa más la tendencia que el número absoluto.
- Tarjetas levantadas y tarjetas cerradas por semana, más la edad mediana de las abiertas. Que las tarjetas levantadas caigan a cero no es un éxito: suele significar que la gente dejó de mirar.
- Cumplimiento de la rutina según la lista auditada, reportado con honestidad. Una rutina que no se hizo es un dato sobre el tiempo disponible, no un asunto disciplinario.
Revise el tiempo de paro a diario en el tablero, haga el Pareto de las pérdidas cada mes y deje que el Pareto elija la siguiente mejora enfocada y la siguiente máquina. Cómo se agregan esas pérdidas en el OEE se explica en su propia guía, y la disciplina de línea base es la misma que para cualquier otro número de los KPI de producción de la planta: definido una vez, capturado en el proceso, seguido contra sí mismo.
Quién responde de qué en la máquina
El mantenimiento autónomo despierta dos miedos que casi nunca se dicen en voz alta. Mantenimiento lo lee como que los operadores van a quedarse con su trabajo; los operadores, como que les cargan trabajo de mantenimiento sin pagarlo. A ambos se les responde igual: con un reparto escrito de responsabilidades por máquina, acordado por las tres partes antes de que arranque el paso 1. El reparto de abajo sirve como punto de partida para una máquina. Ajuste las líneas a su equipo, pero conserve el principio de que cada tarea tiene exactamente un responsable.
| Rol | De qué responde a diario | Cuándo escala |
|---|---|---|
| Operador | Limpiar, inspeccionar y lubricar cada día según el estándar CIL; apretar lo que lleva marca de referencia; primera respuesta ante paros menores; levantar una tarjeta de defecto para todo lo que exceda el estándar. | Todo lo que no se resuelva en minutos va a una tarjeta en el mismo turno. Un hallazgo con implicación de seguridad detiene la máquina y llama a mantenimiento de inmediato. |
| Mantenimiento | Reparaciones mayores planificadas y reemplazos por tiempo; verificaciones predictivas donde justifiquen su costo; reparaciones más allá de la primera respuesta; clasificación y cierre de las tarjetas de defecto. | Un modo de falla que reaparece después de una reparación correcta pasa a ingeniería con el historial de fallas adjunto. |
| Ingeniería | Eliminar por diseño los modos de falla recurrentes: mejora de componentes, supresión de fuentes de contaminación, cambios de especificación, mejoras de mantenibilidad. | Las soluciones que requieren inversión o una ventana de producción fuera de la autoridad del área pasan a la revisión mensual, que decide. |
La ruta de escalación es parte del reparto, no un añadido posterior. Una tarjeta levantada en el mismo turno, una máquina detenida ante hallazgos de seguridad y una entrega documentada a ingeniería para las fallas repetidas: cuando esas tres rutas funcionan, los roles se mantienen limpios. Cuando no, en un trimestre todo vuelve a ser calladamente problema de mantenimiento.
Errores frecuentes
Cómo se ve lo que va mal
- Mantenimiento autónomo presentado como trabajo extra no pagado encima de metas de producción que no cambian
- Limpiar sin sentido de inspección: la máquina brilla y se avería exactamente con la misma frecuencia
- Ventanas de mantenimiento planificado que producción rechaza semana tras semana, hasta que el rezago provoca una avería en el peor momento
- Ocho pilares, un comité directivo y un plan maestro antes de que una sola máquina alcance sus condiciones básicas
- Tarjetas de defecto de la primera limpieza profunda todavía abiertas tres meses después
Cómo se ve lo que va bien
- Los minutos de la rutina diaria planificados en cada turno, de forma visible
- Cada paso de limpieza sirve además como inspección, con un modo de falla conocido detrás
- Ventanas de mantenimiento protegidas como pedidos de cliente, porque lo son
- Una máquina cuello de botella a través de los cinco pasos antes de hablar de despliegue
- Rezago de tarjetas a la baja, revisado cada semana, con la edad mediana de las abiertas en el tablero
Qué habilita un equipo estable
El fruto del TPM no son máquinas más brillantes: es un flujo sobre el que ya se puede planificar. Un equipo que responde cuando el programa lo necesita es lo que permite reducir los lotes y sostener los sistemas pull, porque cada tamaño de supermercado y cada plan de cambio de modelo dan por supuesto, en silencio, que la máquina estará disponible. Por eso el TPM y la reducción del tiempo de cambio suelen correr como hermanos sobre el mismo cuello de botella: uno ataca los 33 minutos de avería, el otro los 47 minutos de cambio, y juntos compran la disponibilidad sobre la que se construye el flujo.
Las rutinas necesitan además un sitio que sobreviva a los cambios de turno y a los trimestres cargados. En TeamGuru, las rutinas CIL diarias corren como checklists programadas cuyos hallazgos con foto se convierten en acciones con responsable, y el tiempo de paro, el MTBF y el rezago de tarjetas viven en los mismos tableros diarios que el resto de los números de la planta, de modo que la salud de la máquina se revisa en los mismos cinco minutos que la seguridad y la entrega.
En la hoja de ruta, los métodos de equipo corren en paralelo con el flujo de kaizen y lo alimentan: cada Pareto mensual de pérdidas entrega la siguiente mejora enfocada a un equipo y, cuando la máquina cuello de botella sostiene sus avances, los mismos cinco pasos pasan a la siguiente máquina que señalan los datos.
Lléveselo consigo
El diagrama de esta guía como imagen, de uso libre en formaciones internas y talleres.
Descargar PNGPreguntas frecuentes
¿Qué significan las siglas TPM?
¿Cuál es la diferencia entre TPM y mantenimiento preventivo?
¿Por dónde debe empezar una planta con el TPM?
¿Cuánto tiempo de operador consume el mantenimiento autónomo por turno?
¿Hace falta un software CMMS antes de arrancar el TPM?
¿Cuánto tarda en bajar el número de averías?
Cómo lo lleva a la práctica TeamGuru